
Передача данных из Logs API в Yandex ClickHouse
21.05.2024
3 мин
Александр Полумордвинов
Специалист по веб- и сквозной аналитике, фокусирующийся на сборе, объединении и интерпретации данных. Использует Python для работы с данными и их анализа. Уверенно работает с различными БД и BI-инструментами, строя информативные дашборды любой сложности.
- Опыт работы:
- 1 год
Вступление
Чтобы осуществить подробный анализ и эффективно работать с сырыми данными, необходимо сначала выгрузить их в специализированное хранилище. Одним из ключевых инструментов для этого является LogsAPI, предоставляемый платформой Яндекс.Метрика. LogsAPI обеспечивает доступ к детализированным журналам посещений и действий пользователей, что является необходимым шагом для дальнейшего анализа.
После получения сырых данных через LogsAPI следует выбрать подходящее хранилище для их обработки и анализа. Среди наиболее распространенных инструментов можно выделить BigQuery и ClickHouse.
ClickHouse - открытое программное обеспечение, специализирующееся на аналитике в реальном времени на основе колоночного хранилища данных. Его высокая производительность и эффективное сжатие данных делают его идеальным выбором для анализа больших объемов данных, полученных, например, через LogsAPI. Это особенно ценно для задач, требующих быстрого доступа к данным, таких как анализ веб-трафика и решение задач аналитики в реальном времени.
Приведенный выше пример представляет лишь один из множества возможных сценариев использования LogsAPI для анализа данных Яндекс.Метрики в ClickHouse.
Написание кода
Изначально, для начала написания кода нам потребуется несколько дополнительных действий, а именно:
Зарегистрировать приложение для получения API токена для возможности выгрузки данных из Logs API. Сделать это можно по ссылке: https://oauth.yandex.ru/client/new
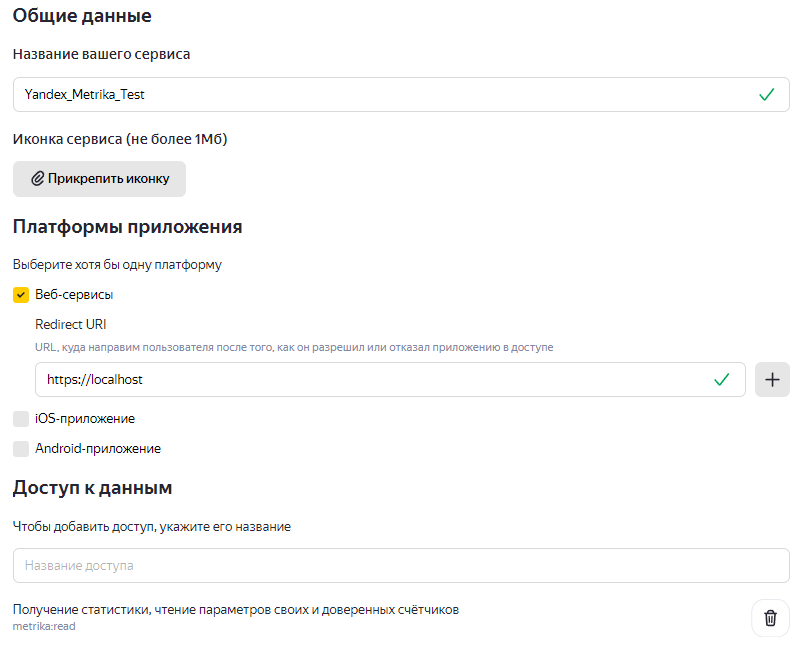
Благодаря этому мы получаем необходимый ClientID
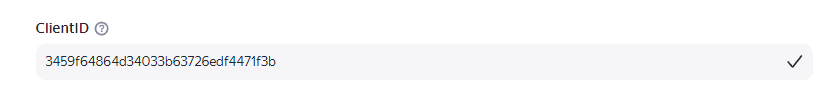
Теперь мы можем перейти по данной ссылке: "https://oauth.yandex.ru/authorize?response_type=code&client_id=идентификатор_приложения"
Где необходимо указать наш ClientID для получения токена.
При входе вы увидите экран подтверждения OAuth, на котором важно внимательно проверить данные вашего сервиса и аккаунта. Убедитесь, что выбран нужный аккаунт, из которого планируется выгрузка данных из метрики.
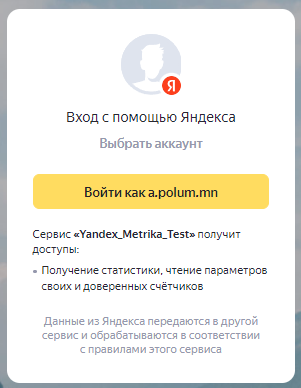
После выбора аккаунта в URL вы должны увидеть redirect_uri, указанный в настройках вашего приложения. Здесь вы найдете необходимый код для получения авторизационного токена Logs API. В нашем тестовом случае это будет “7787242”

Теперь мы можем приступать к написанию кода для получения авторизационного токена.
Изначально импортируем все необходимые нам библиотеки
import pandas as pd
import requests
import io
import time
import io
import clickhouse_connect
# Необходимо установить через pip install clickhouse_connect
Далее выполняем запрос на создание токена доступа на основе полученного кода из п.5
req_url = 'https://oauth.yandex.ru/token'
params = {
    'grant_type': 'authorization_code',
    'code': {'{здесь указываем полученный выше код}'},
    'client_id': '{'{Client_ID из нашего приложения (см. п.2)}'}',
    'client_secret': '{'{Также находится на одной вкладке с нашим Client_ID из п.2}'}'
}
yandex_credentials_req = requests.post(req_url, data=params)
yandex_credentials_req
После чего просматриваем сам токен
yandex_credentials_req.json()Нам выдает следующие значения
{'{'access_token': 'y0_AgAAAAB07AV0AAuYHgAAAAEBayEd8989898AADNJwf5YylFnJpUlqpPrJB940o2qQ',
 'expires_in': 31536000,
 'refresh_token': '1:GCtf0wRvziQQ50PP:vikQO_m-TSVaLBKNPIdIAJoo-KPhgvncxaThfnuWBmYvLlf0QOyC1XD9ktib-cNENnFchubnnOXVL7eFCw:XCiwmIUp01T0ifeP_NFsjg',
 'token_type': 'bearer'}'}
Где:
- access_token: Это токен доступа, используемый для аутентификации
- expires_in: Этот элемент указывает продолжительность времени, в течение которого токен доступа действителен, обычно выраженную в секундах. В данном случае - 31536000 секунд, что эквивалентно 1 году.
- refresh_token: Это токен, который можно использовать для получения нового токена доступа после истечения срока действия текущего.
- token_type: Этот элемент указывает тип токена, в данном случае - 'bearer'.
Далее нам необходимо обозначить все переменные для дальнейшей работы, а именно:
access_token = "YOUR API TOKEN" # API токен
request_headers = {'Authorization': f'OAuth {'{access_token}'}'}
start_date = "2024-01-01" # Дата начала выгрузки в формате %Y-%m-%d
end_date = "2024-01-02" # Дата конца выгрузки в формате %Y-%m-%d
logs_source = 'visits' # Источник логов. Возможные значения - visits и hits
attribution = "cross_device_last_significant" # Полный список возможных значений: https://yandex.ru/dev/metrika/doc/api2/logs/param.html
logs_fields = ("ym:s:dateTimeUTC", "ym:s:visitID", f"ym:s:{'{attribution}'}UTMSource", f"ym:s:{'{attribution}'}UTMMedium") # Указывается список необходимых полей для выгрузки через запятую
counter_id = XXXXXXX # Идентификатор счетичка Яндекс.Метрики
Полный список возможных полей для «Просмотры» - https://yandex.ru/dev/metrika/doc/api2/logs/fields/hits.html
Полный список возможных полей для «Визиты» - https://yandex.ru/dev/metrika/doc/api2/logs/fields/visits.html
Далее сформируем наш запрос для создание логов в LogsAPI и в следующей ячейчке сразу же получим готовые сформированные логи, переведем их вы формат DataFrame для дальнейшей предобработки данных:
params = {'{
    "date1": start_date,
    "date2": end_date,
    "fields": ','.join(logs_fields),
    "source": logs_source,
    "attribution": attribution
}'}
print(f"Сформированные параметры: {'{params}'}")
create_logs_req_url = f"https://api-metrika.yandex.net/management/v1/counter/{'{counter_id}'}/logrequests"
create_logs_req = requests.post(create_logs_req_url, params=params, headers=request_headers)
create_logs_response = create_logs_req.json()
try:
    logs_request_id = create_logs_response
    print(f'Запрос на создание логов был успешно создан. Идентификатор запроса: №{'{logs_request_id}'}.')
except Exception as e:
    print(f'Произошла ошибка при попытке создать запрос на получение логов: {'{e}'}. {'{create_logs_response}'}')
    logs_request_id = 0
Нагрузка на сервис в разное время может различаться, если вам не удалось выгрузить данные, попробуйте позже или в другое время суток. Все запросы выполняются по очереди — каждый новый запрос попадает в конец очереди. Если ваш запрос находится в статусе created, дождитесь его.
sleep_time = 20 # Количество секунд по истечению которых нужно проверять статус готовности логов.
print('Начало процесса получения готовых логов.')
while True:
    # Получение информации о статусе запроса на создание лога.
    get_logs_request_info_url = f"https://api-metrika.yandex.net/management/v1/counter/{'{counter_id}'}/logrequest/{'{logs_request_id}'}"
    get_logs_request_info_req = requests.get(get_logs_request_info_url, headers=request_headers)
    get_logs_request_info_response = get_logs_request_info_req.json()
    try:
        logs_request_info = get_logs_request_info_response
        print(f"Информация о запросе №{'{logs_request_id}'} была успешно получена.")
    except:
        print(f"Ошибка при получении данных о запросе №{'{logs_request_id}'}. {'{get_logs_request_info_response}'}")
        break
    logs_request_status = logs_request_info
    if logs_request_status == 'awaiting_retry':
        print('На данный момент метрика не может сформировать логи. Попробуйте через несколько часов.')
        break
    if logs_request_status != 'created':
        break
    print(f'Логи еще не готовы. Ждем {'{sleep_time}'} секунд. Текущий статус: {'{logs_request_status}'}')
    time.sleep(sleep_time)
if logs_request_status in ():
    print(f'Логи не могут быть обработаны поскольку запрос имеет статус: {'{logs_request_status}'}')
    logs_df = pd.DataFrame()
elif logs_request_status == 'processed':
    logs_parts = list(map(lambda x: x, logs_request_info))
    logs_box =
    print('Перебираем подготовленные части логов.')
    for part in logs_parts:
        download_logs_req_url = f"https://api-metrika.yandex.net/management/v1/counter/{'{counter_id}'}/logrequest/{'{logs_request_id}'}/part/{'{part}'}/download"
        download_logs_req = requests.get(download_logs_req_url, headers=request_headers)
        logs_df = pd.read_csv(io.StringIO(download_logs_req.text), sep = '\t')
        logs_box.append(logs_df)
    logs_df = pd.concat(logs_box, axis=0).reset_index(drop=True)
    print("Готовые логи были успешно получены.")
После этого необходимо очистить готовый запрос логов
if logs_request_status != 'awaiting_retry':
    clean_log_url = f"https://api-metrika.yandex.net/management/v1/counter/{'{counter_id}'}/logrequest/{'{logs_request_id}'}/clean"
    clean_log_req = requests.post(clean_log_url, headers=request_headers)
    try:
        logs_status = clean_log_req.json()
    except Exception as e:
        print(f'Ошибка при очистке лога №{'{logs_request_id}'}. {'{e}'}')
    if logs_status == 'processed' or logs_status == 'cleaned_by_user':
        print(f'Запрос готовых логов №{'{logs_request_id}'} был успешо очищен')
    else:
        print(f'Запрос готовых логов №{'{logs_request_id}'} не был очищен.', logs_status)
Нам также будет необходимо частично предобработать данные для упрощения и корректности нашей дальнейшей работы с ними
# Для начала нужно переименовать колонки в DataFrame, чтобы заменить двоеточия в названиях
logs_df.columns =
# Переведем время в формат datetime
logs_df = pd.to_datetime(logs_df)
logs_df = logs_df.astype(str)
logs_df = logs_df.fillna('not set')
logs_df = logs_df.fillna('not set')
Далее необходимо подключиться к ClickHouse и загрузить уже имеющийся у нас DataFrame в него. Для этого подключимся по заданным ниже параметрам
CH_SOURCE_PARAMS = {'{
    'host': '',
    'port': 8443,
    'username': '',
    'password': '',
    'database': '',
    'secure': False,
    'verify': False
}'}
# Инициализируем подключение к ClickHouse
try:
    source_client = clickhouse_connect.get_client(**CH_SOURCE_PARAMS)
except Exception as e:
    print(f'Произошла ошибка при подключении к ClickHouse. {'{e}'}')
После этого мы должны создать схему таблицы в ClickHouse на основе ранее созданного и предобработанного DataFrame и загрузить данные из нашего DataFrame непосредственно в ClickHouse
DEST_TABLE_NAME = 'logs_api_table' # Имя создаваемой таблицы
columns =
for column_name, dtype in logs_df.dtypes.items():
    clickhouse_type = ""
    if dtype == "int64":
        clickhouse_type = "Int64"
    elif dtype == "float64":
        clickhouse_type = "Float64"
    elif dtype == "Int64":
        clickhouse_type = "Int64"
    elif dtype == "bool":
        clickhouse_type = "Bool"
    elif dtype == "datetime64":
        clickhouse_type = "DateTime"
    elif dtype == "datetime64":
        clickhouse_type = "DateTime"
    else:
        clickhouse_type = "String"
    columns.append(f"{'{column_name}'} {'{clickhouse_type}'}")
create_table_query = f"CREATE TABLE IF NOT EXISTS {'{CH_SOURCE_PARAMS}'}.{'{DEST_TABLE_NAME}'} ({'{', '.join(columns)}'}) ENGINE = MergeTree() ORDER BY tuple()"
try:
    source_client.command(create_table_query)
    print(f"Схема таблицы {'{CH_SOURCE_PARAMS}'}.{'{DEST_TABLE_NAME}'} была успешно создана.")
except Exception as e:
    print(f"Ошибка при создании схемы таблицы. {'{e}'}")
Загружаем данные из нашего DataFrame в созданную схему таблицы в ClickHouse
BATCH_SIZE = 1000
offset = 0
total_rows_fetched = 0
total_rows = len(logs_df)
for i in range(0, total_rows, BATCH_SIZE):
    data = .to_numpy()]
    try:
        source_client.insert(DEST_TABLE_NAME, data)
    except Exception as e:
        print(f"Ошибка при загрузке части данных. {'{e}'}")
    offset += BATCH_SIZE
    total_rows_fetched += len(data)
    print(f'Загружено {'{total_rows_fetched}'} строк из {'{total_rows}'}')
В BATCH_SIZE мы указываем размер пакета данных, который будет загружен в базу данных ClickHouse за одну операцию вставки. Например, если у нас установлено значение 1000, а у нас 5000 строк с данными, то данные будут загружены по 1000 строк за один раз 5 раз подряд.
Это полезно при работе с большими объемами данных, т.к. позволяет управлять объемом данных, передаваемых за один запрос, чтобы избежать перегрузки базы данных и оптимизировать процесс загрузки.
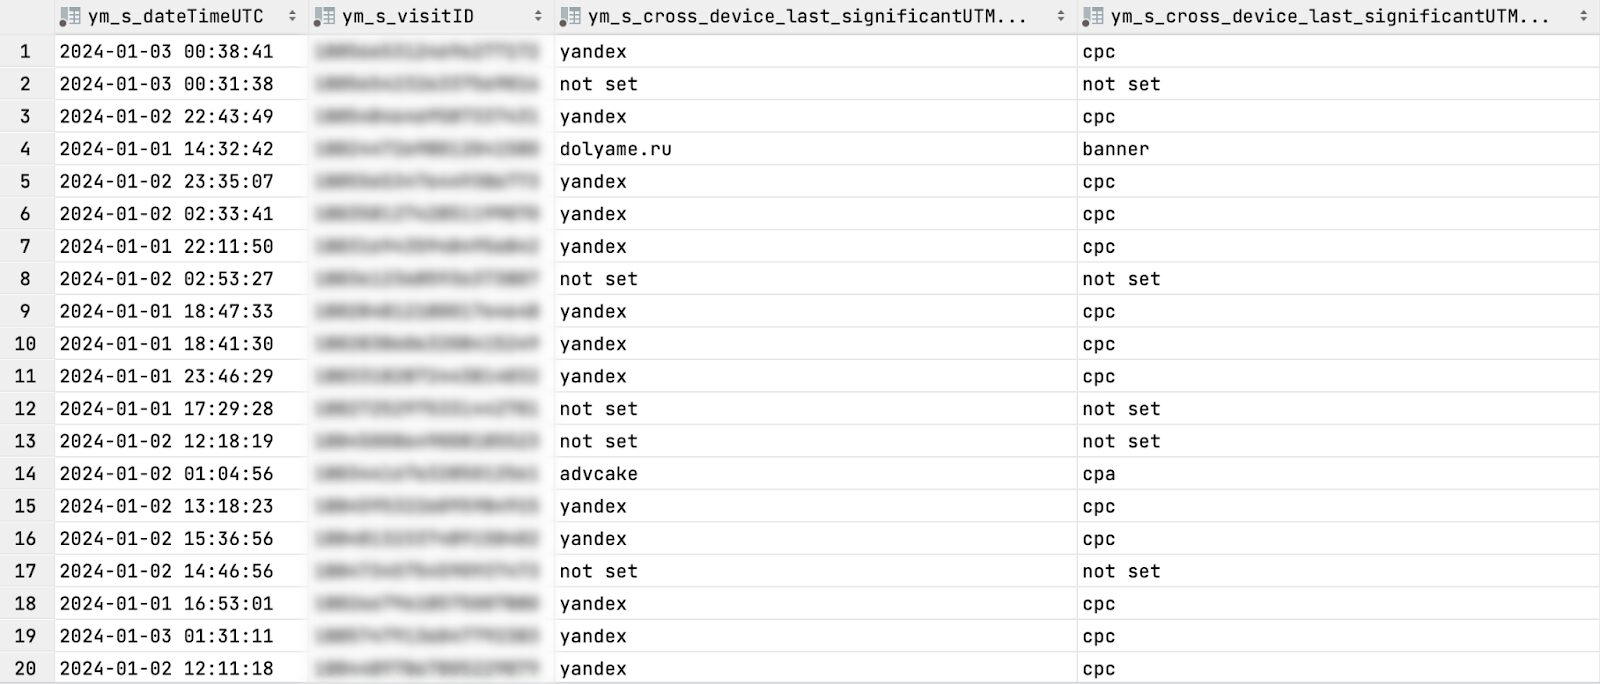
Теперь мы можем увидеть в ClickHouse, что таблица была успешно обогащена данными из DataFrame
Вывод
Благодаря данной статье вы теперь можете самостоятельно выгружать нужные вам данные из LogsAPI в Yandex ClickHouse, при этом редактируя нужные вам поля и их форматы на Python. Это помогает сократить время на обработку данных и улучшить их качество. Возможность гибкой настройки выгружаемых данных позволяет точнее удовлетворить потребности вашего бизнеса. Кроме того, использование Python облегчает автоматизацию и интеграцию с другими аналитическими инструментами.
Больше интересных и полезных статей вы можете найти в нашем блоге


